
#openledger
openledger
17.3M visualizaciones
202,848 participa(n) en el debate
Populares
Novedades
·
--
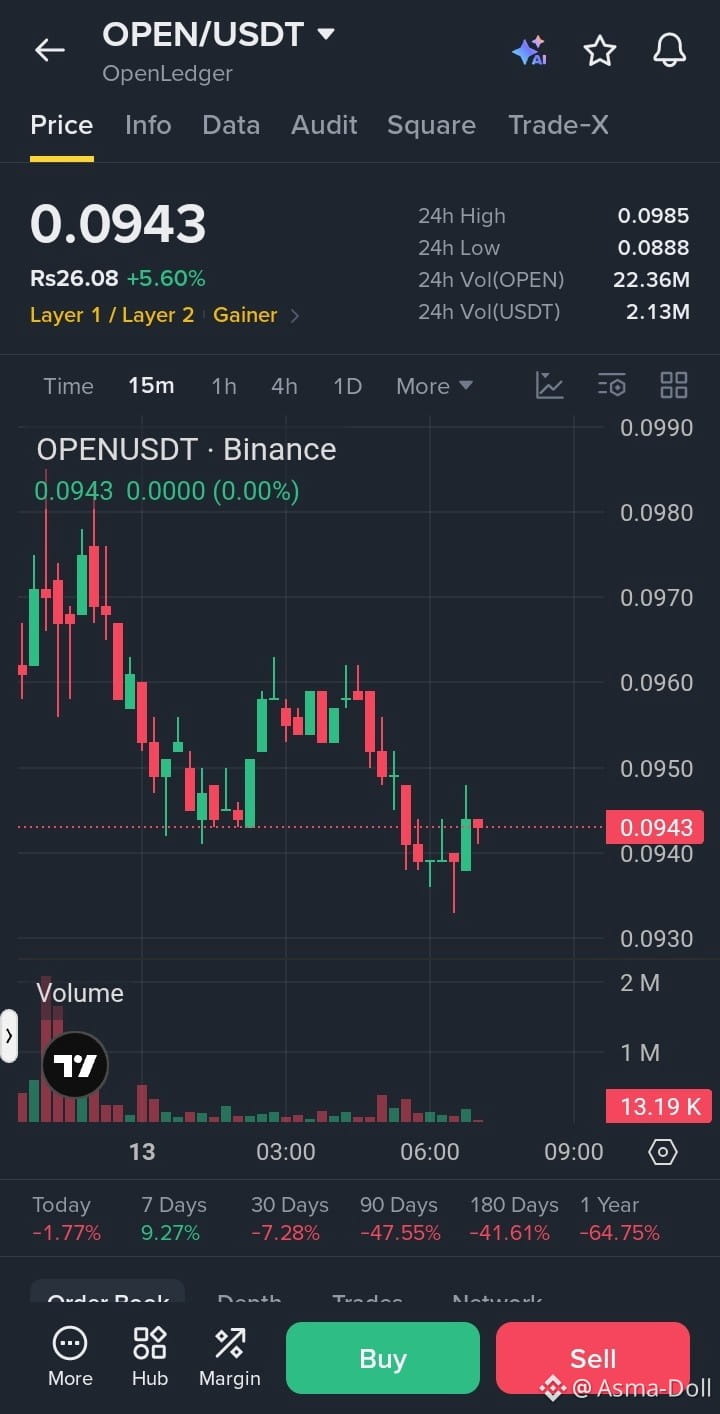
📊 $OPEN /USDT – SEÑAL DE VENTA EN CORTO
Zona de entrada: 0.0945 – 0.0960
Stop loss (SL): 0.0990
Objetivos de toma de ganancias:
* TP1: 0.0920
* TP2: 0.0890
* TP3: 0.0850
Opera aquí $OPEN
{future}(OPENUSDT)
Análisis:
* El precio se enfrenta a un rechazo cerca de la zona de resistencia de 0.0985.
* La ganancia reciente del 5.60% en 24 h indica un posible retroceso a corto plazo.
* El rendimiento de 7 días sigue siendo positivo, en un 9.27%.
* La tendencia a más largo plazo es débil, con un rendimiento de -47.55% en 90 días.
* Una caída por debajo de 0.0930 podría provocar un descenso mayor.
Confirmación:
* Espera una ruptura clara por debajo de 0.0930.
* Se prefiere una vela bajista de 15 min/1 h con un volumen creciente.
* Evita abrir posiciones cortas si el precio rompe y se mantiene por encima de 0.0985.
Relación riesgo-beneficio (aprox.): 1:0.6 hasta TP1, 1:1.3 hasta TP2, 1:2.2 hasta TP3 (usando una entrada en 0.0950 y un SL en 0.0990).
⚠️ Espera la confirmación; esta es una configuración especulativa, no un movimiento garantizado. Arriesga solo lo que puedas permitirte perder.
#OPENUSDT #OPENLedger #SeñalesCripto #FuturosBinance #ShortSetup
📊 $OPEN /USDT – SEÑAL DE VENTA EN CORTO
Zona de entrada: 0.0945 – 0.0960
Stop loss (SL): 0.0990
Objetivos de toma de ganancias:
* TP1: 0.0920
* TP2: 0.0890
* TP3: 0.0850
Opera aquí $OPEN
Análisis:
* El precio se enfrenta a un rechazo cerca de la zona de resistencia de 0.0985.
* La ganancia reciente del 5.60% en 24 h indica un posible retroceso a corto plazo.
* El rendimiento de 7 días sigue siendo positivo, en un 9.27%.
* La tendencia a más largo plazo es débil, con un rendimiento de -47.55% en 90 días.
* Una caída por debajo de 0.0930 podría provocar un descenso mayor.
Confirmación:
* Espera una ruptura clara por debajo de 0.0930.
* Se prefiere una vela bajista de 15 min/1 h con un volumen creciente.
* Evita abrir posiciones cortas si el precio rompe y se mantiene por encima de 0.0985.
Relación riesgo-beneficio (aprox.): 1:0.6 hasta TP1, 1:1.3 hasta TP2, 1:2.2 hasta TP3 (usando una entrada en 0.0950 y un SL en 0.0990).
⚠️ Espera la confirmación; esta es una configuración especulativa, no un movimiento garantizado. Arriesga solo lo que puedas permitirte perder.
#OPENUSDT #OPENLedger #SeñalesCripto #FuturosBinance #ShortSetup
Zona de entrada: 0.0945 – 0.0960
Stop loss (SL): 0.0990
Objetivos de toma de ganancias:
* TP1: 0.0920
* TP2: 0.0890
* TP3: 0.0850
Opera aquí $OPEN
Análisis:
* El precio se enfrenta a un rechazo cerca de la zona de resistencia de 0.0985.
* La ganancia reciente del 5.60% en 24 h indica un posible retroceso a corto plazo.
* El rendimiento de 7 días sigue siendo positivo, en un 9.27%.
* La tendencia a más largo plazo es débil, con un rendimiento de -47.55% en 90 días.
* Una caída por debajo de 0.0930 podría provocar un descenso mayor.
Confirmación:
* Espera una ruptura clara por debajo de 0.0930.
* Se prefiere una vela bajista de 15 min/1 h con un volumen creciente.
* Evita abrir posiciones cortas si el precio rompe y se mantiene por encima de 0.0985.
Relación riesgo-beneficio (aprox.): 1:0.6 hasta TP1, 1:1.3 hasta TP2, 1:2.2 hasta TP3 (usando una entrada en 0.0950 y un SL en 0.0990).
⚠️ Espera la confirmación; esta es una configuración especulativa, no un movimiento garantizado. Arriesga solo lo que puedas permitirte perder.
#OPENUSDT #OPENLedger #SeñalesCripto #FuturosBinance #ShortSetup
44
·
--
Alcista
$OPEN está que arde! 🔥
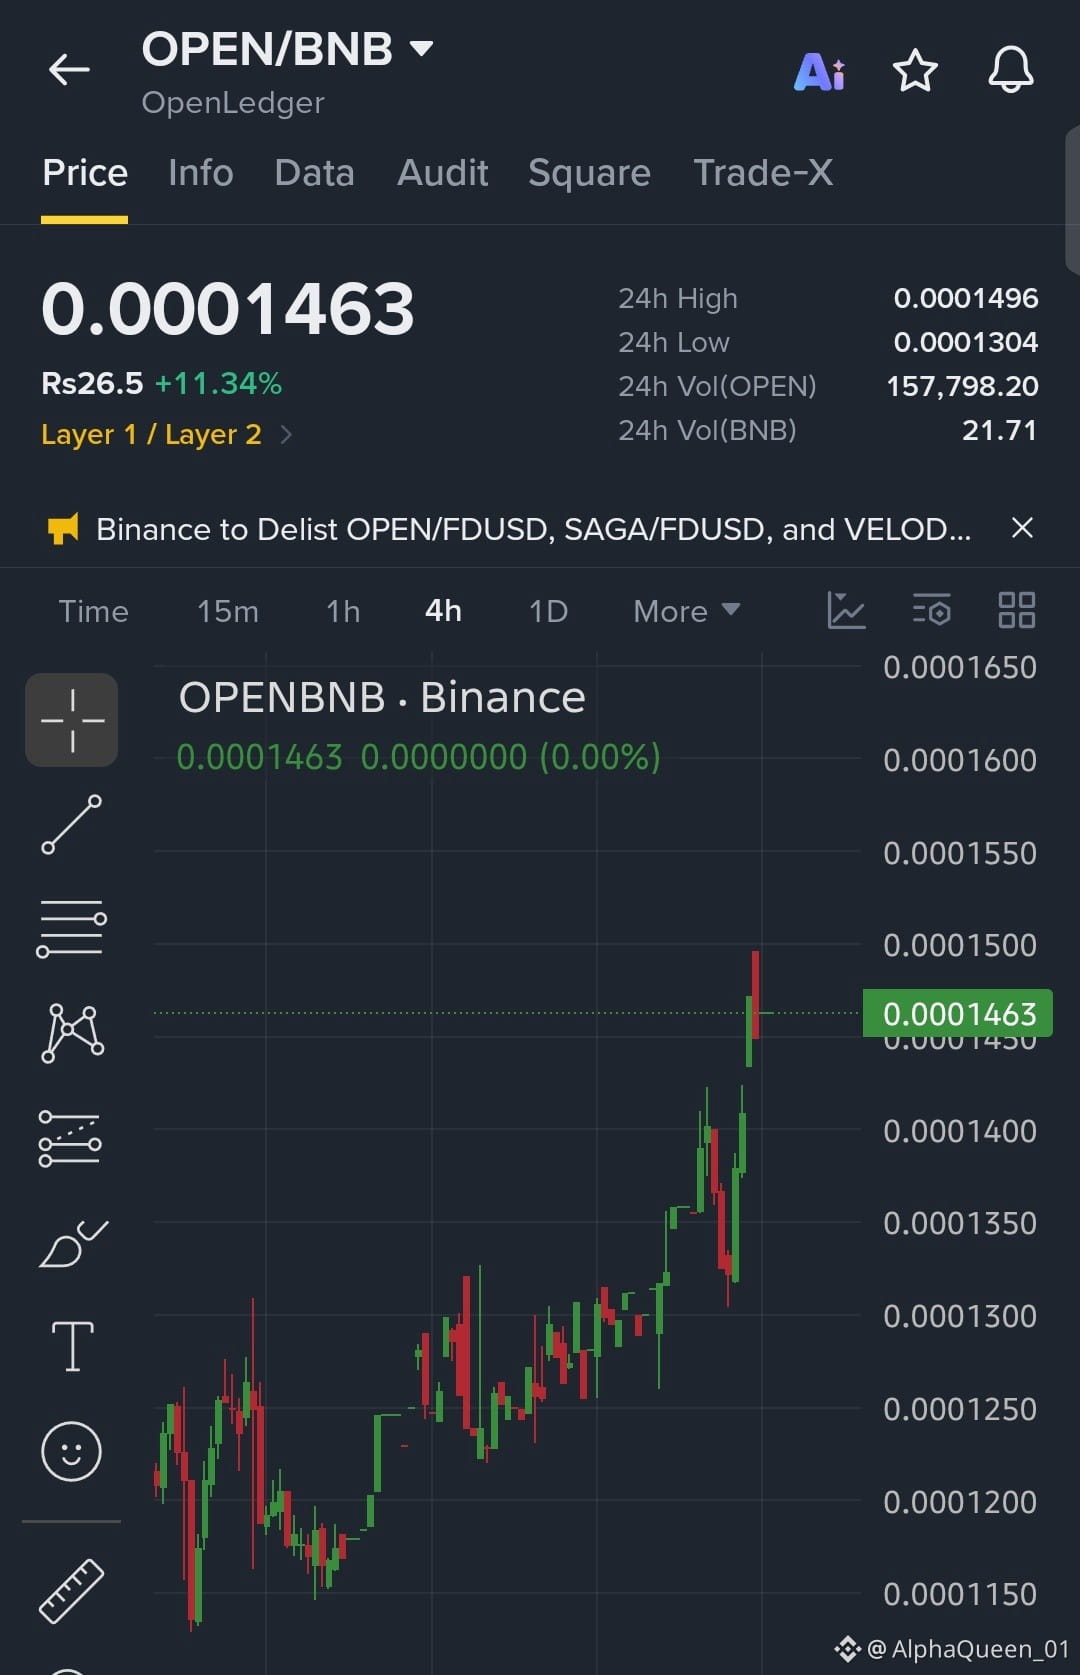
¡$OPEN /BNB a 0.0001463, subiendo un +11.34% hoy!
¡De un mínimo de 0.0001304 a un máximo de 0.0001496: una subida imparable!
Binance dijo que lo excluiría de cotización, y OPEN respondió: «¡Mírame volar!» 🚀
¿Quién sigue teniendo OPEN? Comenta «OPEN ARMY» 👇
#OPEN #OpenLedger #BNB #Crypto
{future}(OPENUSDT)
$OPEN está que arde! 🔥
¡$OPEN /BNB a 0.0001463, subiendo un +11.34% hoy!
¡De un mínimo de 0.0001304 a un máximo de 0.0001496: una subida imparable!
Binance dijo que lo excluiría de cotización, y OPEN respondió: «¡Mírame volar!» 🚀
¿Quién sigue teniendo OPEN? Comenta «OPEN ARMY» 👇
#OPEN #OpenLedger #BNB #Crypto
¡$OPEN /BNB a 0.0001463, subiendo un +11.34% hoy!
¡De un mínimo de 0.0001304 a un máximo de 0.0001496: una subida imparable!
Binance dijo que lo excluiría de cotización, y OPEN respondió: «¡Mírame volar!» 🚀
¿Quién sigue teniendo OPEN? Comenta «OPEN ARMY» 👇
#OPEN #OpenLedger #BNB #Crypto
6
265
·
--
$币安人生 ¡El mercado de las criptomonedas está contando una historia interesante hoy! 🔥 Bitcoin cotiza alrededor de los 71.486,9 $, con una caída del 3,33 %, mientras que ($BTC )(Binance Life) ha bajado un 5,47 %, hasta los 0,4719 $. Pero OpenLedger (OPEN) muestra una tendencia diferente: se mantiene en 0,0971 $, con una subida del 0,83 %.
Lo que hace interesante a OpenLedger es su capacidad para atraer la atención incluso cuando el sentimiento general del mercado está bajo presión. Mientras los operadores observan cuál será el próximo movimiento de Bitcoin, $OPEN plantea una pregunta importante: ¿podría este proyecto cobrar más impulso mientras el mercado busca estabilidad?
¿Está construyendo OpenLedger algo que pueda destacar más allá de los movimientos de precios a corto plazo? ¿Podrá OPEN mantener su fortaleza si Bitcoin sigue enfrentándose a la presión vendedora? ¿Y cuál podría ser el próximo gran catalizador de su ecosistema?
El próximo capítulo aún se está escribiendo. Sigue de cerca los fundamentos, la adopción y la actividad del mercado, en lugar de juzgar el proyecto por una sola vela verde.
¿Se está preparando OPEN para una oportunidad mayor o se trata solo de un rebote temporal del mercado? 👀
{future}(币安人生USDT)
{future}(OPENUSDT)
{future}(BTCUSDT)
#OpenLedger #OPENUSDT #CryptoMarket
$币安人生 ¡El mercado de las criptomonedas está contando una historia interesante hoy! 🔥 Bitcoin cotiza alrededor de los 71.486,9 $, con una caída del 3,33 %, mientras que ($BTC )(Binance Life) ha bajado un 5,47 %, hasta los 0,4719 $. Pero OpenLedger (OPEN) muestra una tendencia diferente: se mantiene en 0,0971 $, con una subida del 0,83 %.
Lo que hace interesante a OpenLedger es su capacidad para atraer la atención incluso cuando el sentimiento general del mercado está bajo presión. Mientras los operadores observan cuál será el próximo movimiento de Bitcoin, $OPEN plantea una pregunta importante: ¿podría este proyecto cobrar más impulso mientras el mercado busca estabilidad?
¿Está construyendo OpenLedger algo que pueda destacar más allá de los movimientos de precios a corto plazo? ¿Podrá OPEN mantener su fortaleza si Bitcoin sigue enfrentándose a la presión vendedora? ¿Y cuál podría ser el próximo gran catalizador de su ecosistema?
El próximo capítulo aún se está escribiendo. Sigue de cerca los fundamentos, la adopción y la actividad del mercado, en lugar de juzgar el proyecto por una sola vela verde.
¿Se está preparando OPEN para una oportunidad mayor o se trata solo de un rebote temporal del mercado? 👀
#OpenLedger #OPENUSDT #CryptoMarket
Lo que hace interesante a OpenLedger es su capacidad para atraer la atención incluso cuando el sentimiento general del mercado está bajo presión. Mientras los operadores observan cuál será el próximo movimiento de Bitcoin, $OPEN plantea una pregunta importante: ¿podría este proyecto cobrar más impulso mientras el mercado busca estabilidad?
¿Está construyendo OpenLedger algo que pueda destacar más allá de los movimientos de precios a corto plazo? ¿Podrá OPEN mantener su fortaleza si Bitcoin sigue enfrentándose a la presión vendedora? ¿Y cuál podría ser el próximo gran catalizador de su ecosistema?
El próximo capítulo aún se está escribiendo. Sigue de cerca los fundamentos, la adopción y la actividad del mercado, en lugar de juzgar el proyecto por una sola vela verde.
¿Se está preparando OPEN para una oportunidad mayor o se trata solo de un rebote temporal del mercado? 👀
#OpenLedger #OPENUSDT #CryptoMarket
$币安人生 🔙👍✅
64%
$BTC 💻📞📱
18%
$OPEN 😀😁😂
18%
11 Votos • Votación cerrada
1
2.5k
·
--
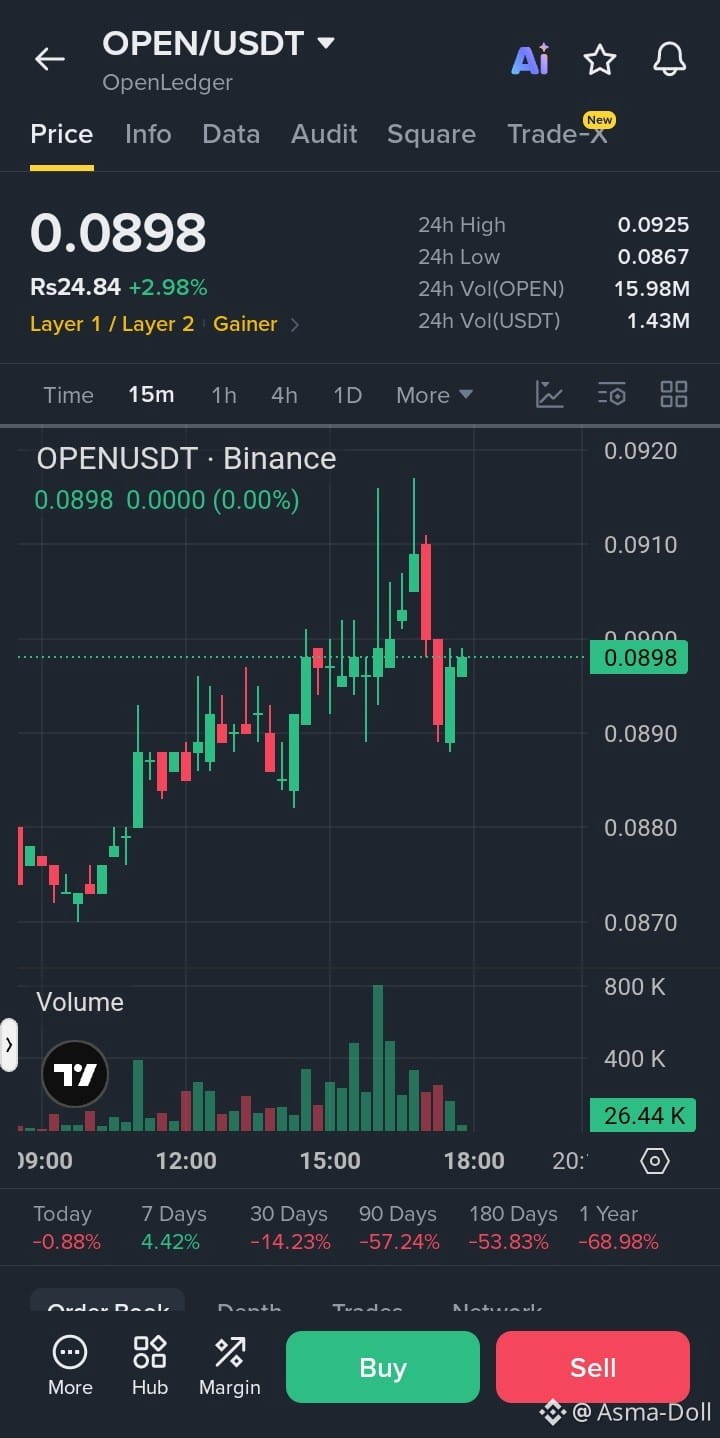
🔴 $OPEN /USDT – SEÑAL CORTA OpenLedger | Configuración bajista
Zona de entrada: 0.0895 – 0.0905
Stop loss (SL): 0.0930
🎯 Toma de ganancias (TP):
TP1: 0.0875
TP2: 0.0855
TP3: 0.0820
Opera aquí $OPEN
{future}(OPENUSDT)
Análisis:
El precio encuentra resistencia cerca de 0.0925.
El rendimiento en 30 días ha bajado un 14.23%.
El rendimiento en 90 días muestra una caída masiva del 57.24%.
La tendencia de 1 año sigue siendo fuertemente bajista.
Un rebote a corto plazo podría enfrentar presión vendedora.
Los compradores necesitan un volumen sólido para revertir la tendencia.
Confirmación: Una ruptura clara por debajo de 0.0880 con un fuerte volumen de ventas podría provocar nuevas caídas.
Riesgo-beneficio: Aproximadamente de 1:1 a 1:2.1, según el punto de entrada y el objetivo.
⚠️ Espera la confirmación bajista antes de entrar. Estos niveles son orientativos, no están garantizados.
#OPENUSDT #OpenLedger #CryptoSignals #BinanceFutures #ShortSignal
🔴 $OPEN /USDT – SEÑAL CORTA OpenLedger | Configuración bajista
Zona de entrada: 0.0895 – 0.0905
Stop loss (SL): 0.0930
🎯 Toma de ganancias (TP):
TP1: 0.0875
TP2: 0.0855
TP3: 0.0820
Opera aquí $OPEN
Análisis:
El precio encuentra resistencia cerca de 0.0925.
El rendimiento en 30 días ha bajado un 14.23%.
El rendimiento en 90 días muestra una caída masiva del 57.24%.
La tendencia de 1 año sigue siendo fuertemente bajista.
Un rebote a corto plazo podría enfrentar presión vendedora.
Los compradores necesitan un volumen sólido para revertir la tendencia.
Confirmación: Una ruptura clara por debajo de 0.0880 con un fuerte volumen de ventas podría provocar nuevas caídas.
Riesgo-beneficio: Aproximadamente de 1:1 a 1:2.1, según el punto de entrada y el objetivo.
⚠️ Espera la confirmación bajista antes de entrar. Estos niveles son orientativos, no están garantizados.
#OPENUSDT #OpenLedger #CryptoSignals #BinanceFutures #ShortSignal
Zona de entrada: 0.0895 – 0.0905
Stop loss (SL): 0.0930
🎯 Toma de ganancias (TP):
TP1: 0.0875
TP2: 0.0855
TP3: 0.0820
Opera aquí $OPEN
Análisis:
El precio encuentra resistencia cerca de 0.0925.
El rendimiento en 30 días ha bajado un 14.23%.
El rendimiento en 90 días muestra una caída masiva del 57.24%.
La tendencia de 1 año sigue siendo fuertemente bajista.
Un rebote a corto plazo podría enfrentar presión vendedora.
Los compradores necesitan un volumen sólido para revertir la tendencia.
Confirmación: Una ruptura clara por debajo de 0.0880 con un fuerte volumen de ventas podría provocar nuevas caídas.
Riesgo-beneficio: Aproximadamente de 1:1 a 1:2.1, según el punto de entrada y el objetivo.
⚠️ Espera la confirmación bajista antes de entrar. Estos niveles son orientativos, no están garantizados.
#OPENUSDT #OpenLedger #CryptoSignals #BinanceFutures #ShortSignal
19
·
--
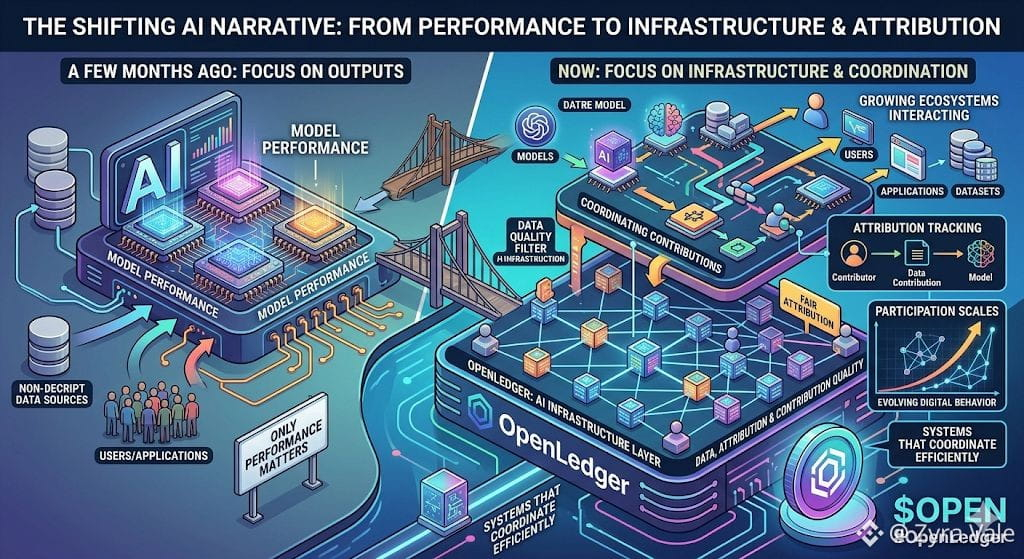
Siento que la narrativa de la IA está cambiando lentamente últimamente.
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @Openledger
Siento que la narrativa de la IA está cambiando lentamente últimamente.
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @OpenLedger
hace unos meses, a la mayoría de la gente solo le importaba el rendimiento del modelo.
ahora estoy notando más conversaciones sobre datos, atribución y calidad de contribución también.
esa es parte de la razón por la que OpenLedger ha comenzado a destacar para mí recientemente.
el proyecto se siente enfocado en una capa de infraestructura de IA que probablemente se vuelva más importante a medida que los ecosistemas crezcan.
especialmente una vez que más usuarios, aplicaciones y conjuntos de datos empiecen a interactuar a través de redes.
el cripto ya mostró qué tan rápido evoluciona el comportamiento digital una vez que la participación escala.
así que los sistemas que pueden coordinar contribuciones y atribuciones de manera más eficiente podrían terminar convirtiéndose en una parte bastante importante del ecosistema de IA más adelante.
obviamente todavía es temprano.
pero siento que el mercado está comenzando gradualmente a prestar más atención a la infraestructura subyacente de la IA en lugar de solo a los resultados.
esa es principalmente la razón por la que he estado observando $OPEN últimamente.
#openledger $OPEN @OpenLedger
2
185
·
--
Últimamente he estado diseñando un proceso automatizado de colaboración entre múltiples agentes, y cada vez más siento que la visión de @Openledger de "miles de agentes llamándose y liquidándose automáticamente entre sí" suena sexy, pero al implementarla hay un peligro de ingeniería mortal oculto: la propagación en cascada de fallos.
Primero, hablemos de mi escenario real. Tengo tres microservicios: A se encarga de capturar datos en la cadena, B limpia los datos y los convierte en informes estructurados, y C toma decisiones basadas en esos informes. En un sistema centralizado, puedo agregar tiempos de espera, reintentos y cortafuegos a cada etapa; una vez que A falla, C puede detectarlo de inmediato y degradar su funcionamiento, evitando así que corra con datos corruptos. Este mecanismo de tolerancia a fallos es algo que he ajustado localmente durante mucho tiempo hasta que se estabilizó.
Ahora, llevar este sistema a la red descentralizada de OpenLedger es un desafío que se dispara. Cuando el agente C compra automáticamente informes a B y B automáticamente paga a A por los datos, toda la cadena de llamadas es completamente automática y desatendida. Aquí viene el problema: si el nodo de A se queda sin energía, pierde la conexión o se cae, ¿cómo se propagará la falla a lo largo de la cadena?
La situación más aterradora es que A no se ha caído del todo, sino que devuelve un resultado que "parece normal, pero en realidad es un dato corrupto". B no cuestionará nada, aceptará todo y limpiará los datos para convertirlos en un informe, y C, con ese informe basado en datos corruptos, ejecutará sin dudarlo una transacción real en la cadena. Cuando te des cuenta de que algo no está bien, ya habrás sufrido la pérdida, y como es una ejecución completamente automática, nadie puede presionar el botón de pausa a tiempo. $LAB
En un sistema centralizado, puedo monitorear, detener y revertir esto en cualquier momento. Pero en una red descentralizada totalmente automatizada y en caja negra, nadie puede "operar" esta cadena que avanza a toda velocidad. Aunque el sistema después pueda compensar a través de un contrato inteligente al despojar el depósito de A (Slash), mi negocio ya habrá sufrido una paralización devastadora debido a esta falla en cascada.
Así que, objetivamente, la dirección de la combinabilidad de los agentes de OpenLedger es correcta, realmente ha tocado la tendencia de la economía de máquinas. Pero "perder datos puede costar dinero" es, sin duda, muy poco; para un uso comercial serio, se necesita que "la cadena no puede equivocarse ni un segundo". No te quedes solo mirando lo impresionante de la liquidación automática, examina su diseño real en tolerancia a fallos y interrupciones en cascada, mantente neutral y haz tu propia investigación, DYOR. #BTC
#OpenLedger $OPEN @Openledger
{future}(LABUSDT)
{spot}(OPENUSDT)
Últimamente he estado diseñando un proceso automatizado de colaboración entre múltiples agentes, y cada vez más siento que la visión de @OpenLedger de "miles de agentes llamándose y liquidándose automáticamente entre sí" suena sexy, pero al implementarla hay un peligro de ingeniería mortal oculto: la propagación en cascada de fallos.
Primero, hablemos de mi escenario real. Tengo tres microservicios: A se encarga de capturar datos en la cadena, B limpia los datos y los convierte en informes estructurados, y C toma decisiones basadas en esos informes. En un sistema centralizado, puedo agregar tiempos de espera, reintentos y cortafuegos a cada etapa; una vez que A falla, C puede detectarlo de inmediato y degradar su funcionamiento, evitando así que corra con datos corruptos. Este mecanismo de tolerancia a fallos es algo que he ajustado localmente durante mucho tiempo hasta que se estabilizó.
Ahora, llevar este sistema a la red descentralizada de OpenLedger es un desafío que se dispara. Cuando el agente C compra automáticamente informes a B y B automáticamente paga a A por los datos, toda la cadena de llamadas es completamente automática y desatendida. Aquí viene el problema: si el nodo de A se queda sin energía, pierde la conexión o se cae, ¿cómo se propagará la falla a lo largo de la cadena?
La situación más aterradora es que A no se ha caído del todo, sino que devuelve un resultado que "parece normal, pero en realidad es un dato corrupto". B no cuestionará nada, aceptará todo y limpiará los datos para convertirlos en un informe, y C, con ese informe basado en datos corruptos, ejecutará sin dudarlo una transacción real en la cadena. Cuando te des cuenta de que algo no está bien, ya habrás sufrido la pérdida, y como es una ejecución completamente automática, nadie puede presionar el botón de pausa a tiempo. $LAB
En un sistema centralizado, puedo monitorear, detener y revertir esto en cualquier momento. Pero en una red descentralizada totalmente automatizada y en caja negra, nadie puede "operar" esta cadena que avanza a toda velocidad. Aunque el sistema después pueda compensar a través de un contrato inteligente al despojar el depósito de A (Slash), mi negocio ya habrá sufrido una paralización devastadora debido a esta falla en cascada.
Así que, objetivamente, la dirección de la combinabilidad de los agentes de OpenLedger es correcta, realmente ha tocado la tendencia de la economía de máquinas. Pero "perder datos puede costar dinero" es, sin duda, muy poco; para un uso comercial serio, se necesita que "la cadena no puede equivocarse ni un segundo". No te quedes solo mirando lo impresionante de la liquidación automática, examina su diseño real en tolerancia a fallos y interrupciones en cascada, mantente neutral y haz tu propia investigación, DYOR. #BTC
#OpenLedger $OPEN @OpenLedger
Primero, hablemos de mi escenario real. Tengo tres microservicios: A se encarga de capturar datos en la cadena, B limpia los datos y los convierte en informes estructurados, y C toma decisiones basadas en esos informes. En un sistema centralizado, puedo agregar tiempos de espera, reintentos y cortafuegos a cada etapa; una vez que A falla, C puede detectarlo de inmediato y degradar su funcionamiento, evitando así que corra con datos corruptos. Este mecanismo de tolerancia a fallos es algo que he ajustado localmente durante mucho tiempo hasta que se estabilizó.
Ahora, llevar este sistema a la red descentralizada de OpenLedger es un desafío que se dispara. Cuando el agente C compra automáticamente informes a B y B automáticamente paga a A por los datos, toda la cadena de llamadas es completamente automática y desatendida. Aquí viene el problema: si el nodo de A se queda sin energía, pierde la conexión o se cae, ¿cómo se propagará la falla a lo largo de la cadena?
La situación más aterradora es que A no se ha caído del todo, sino que devuelve un resultado que "parece normal, pero en realidad es un dato corrupto". B no cuestionará nada, aceptará todo y limpiará los datos para convertirlos en un informe, y C, con ese informe basado en datos corruptos, ejecutará sin dudarlo una transacción real en la cadena. Cuando te des cuenta de que algo no está bien, ya habrás sufrido la pérdida, y como es una ejecución completamente automática, nadie puede presionar el botón de pausa a tiempo. $LAB
En un sistema centralizado, puedo monitorear, detener y revertir esto en cualquier momento. Pero en una red descentralizada totalmente automatizada y en caja negra, nadie puede "operar" esta cadena que avanza a toda velocidad. Aunque el sistema después pueda compensar a través de un contrato inteligente al despojar el depósito de A (Slash), mi negocio ya habrá sufrido una paralización devastadora debido a esta falla en cascada.
Así que, objetivamente, la dirección de la combinabilidad de los agentes de OpenLedger es correcta, realmente ha tocado la tendencia de la economía de máquinas. Pero "perder datos puede costar dinero" es, sin duda, muy poco; para un uso comercial serio, se necesita que "la cadena no puede equivocarse ni un segundo". No te quedes solo mirando lo impresionante de la liquidación automática, examina su diseño real en tolerancia a fallos y interrupciones en cascada, mantente neutral y haz tu propia investigación, DYOR. #BTC
#OpenLedger $OPEN @OpenLedger
自动调用链断了怎么办
50%
Agent 协作扛得住故障吗
50%
2 Votos • Votación cerrada
2
1
455
·
--
El motor de valor de OpenLedgerAl evaluar la viabilidad a largo plazo de una Red de Infraestructura Física Descentralizada (DePIN), el modelo de tokenómica debe ser lo bastante sólido como para sostener contribuciones de hardware físico. Un proyecto no puede depender solo del hype; necesita un ciclo autosostenible. Por eso mismo, el plano económico de @Openledger está atrayendo un gran interés por parte de los desarrolladores.
La relación entre la red y su activo nativo, el $OPEN token, se basa en una utilidad sólida. A medida que las aplicaciones descentralizadas y las empresas aprovechan la red para el almacenamiento de datos seguro y la computación verificable, utilizan activamente $OPEN to para liquidar los costos de transacción y asegurar el ancho de banda operativo. Esta demanda continua recompensa a los proveedores de nodos que mantienen la infraestructura segura, formando un ciclo de crecimiento saludable. Mientras la creación global de datos sigue creciendo de forma exponencial, establecer un mercado descentralizado para procesar esos datos sitúa este protocolo en la absoluta vanguardia de la innovación en Web3. #OpenLedger
El motor de valor de OpenLedger
Al evaluar la viabilidad a largo plazo de una Red de Infraestructura Física Descentralizada (DePIN), el modelo de tokenómica debe ser lo bastante sólido como para sostener contribuciones de hardware físico. Un proyecto no puede depender solo del hype; necesita un ciclo autosostenible. Por eso mismo, el plano económico de @OpenLedger está atrayendo un gran interés por parte de los desarrolladores.
La relación entre la red y su activo nativo, el $OPEN token, se basa en una utilidad sólida. A medida que las aplicaciones descentralizadas y las empresas aprovechan la red para el almacenamiento de datos seguro y la computación verificable, utilizan activamente $OPEN to para liquidar los costos de transacción y asegurar el ancho de banda operativo. Esta demanda continua recompensa a los proveedores de nodos que mantienen la infraestructura segura, formando un ciclo de crecimiento saludable. Mientras la creación global de datos sigue creciendo de forma exponencial, establecer un mercado descentralizado para procesar esos datos sitúa este protocolo en la absoluta vanguardia de la innovación en Web3. #OpenLedger
La relación entre la red y su activo nativo, el $OPEN token, se basa en una utilidad sólida. A medida que las aplicaciones descentralizadas y las empresas aprovechan la red para el almacenamiento de datos seguro y la computación verificable, utilizan activamente $OPEN to para liquidar los costos de transacción y asegurar el ancho de banda operativo. Esta demanda continua recompensa a los proveedores de nodos que mantienen la infraestructura segura, formando un ciclo de crecimiento saludable. Mientras la creación global de datos sigue creciendo de forma exponencial, establecer un mercado descentralizado para procesar esos datos sitúa este protocolo en la absoluta vanguardia de la innovación en Web3. #OpenLedger
1
88
·
--
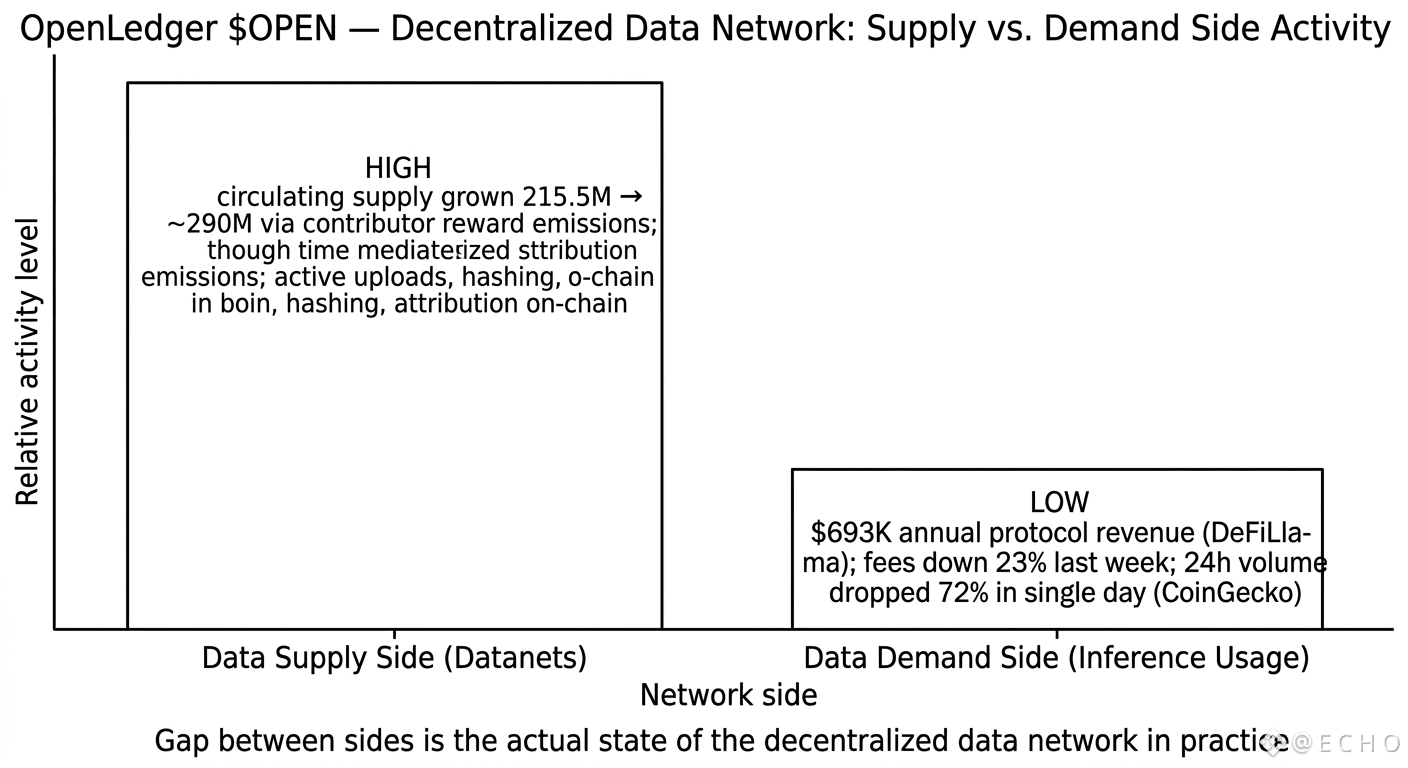
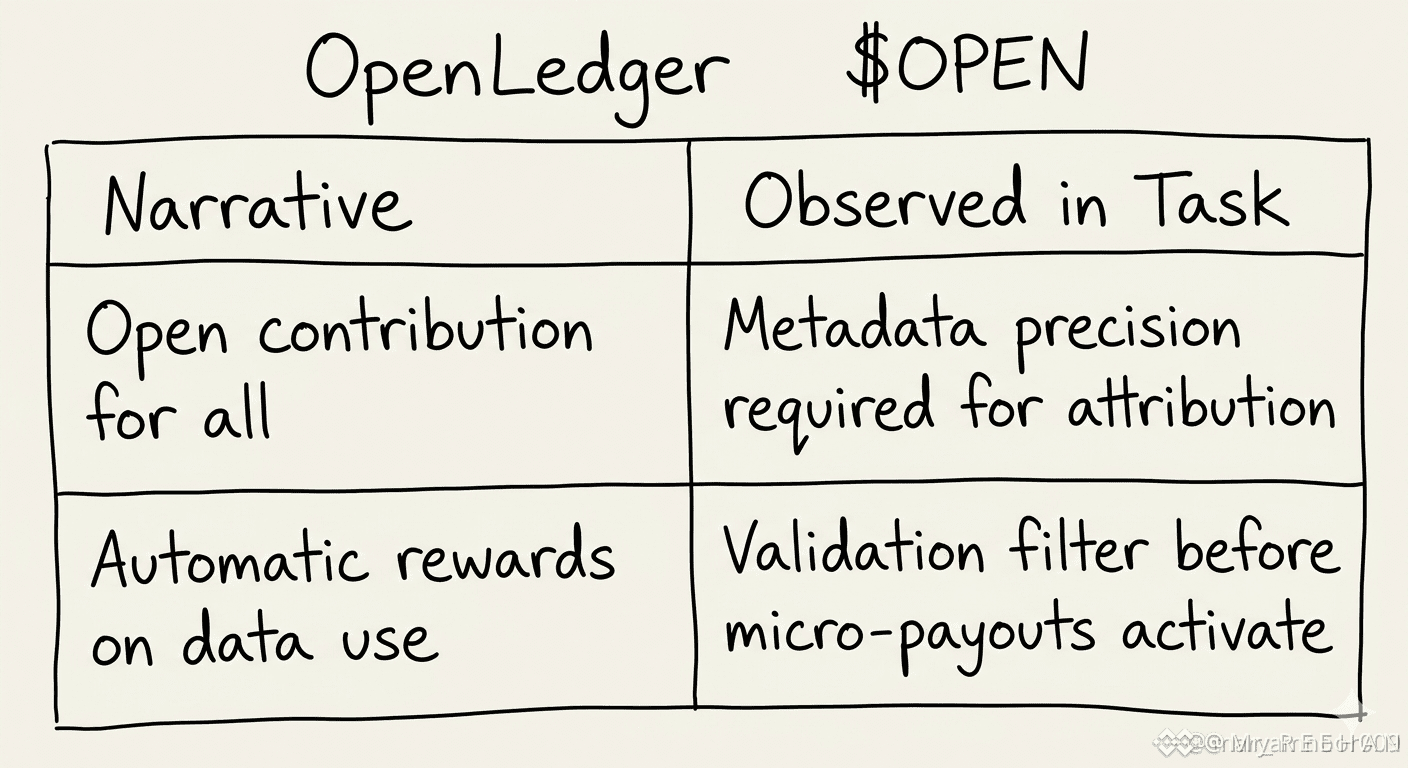
Lo que me llamó la atención durante la tarea de OpenLedger $OPEN #OpenLedger @Openledger no fue la infraestructura — que es realmente interesante — sino darme cuenta de qué mitad de la red de datos está realmente funcionando. Las datanets están creciendo. Los colaboradores están subiendo, etiquetando, haciendo hashing. El lado de la oferta de la historia de datos descentralizados está activo y siendo recompensado a través de emisiones de tokens — la oferta circulante ha aumentado de 215.5M a aproximadamente 290M OPEN desde el TGE, según CoinMarketCap. Ese crecimiento es real y muestra que la gente está participando.
El lado de la demanda es una historia diferente. DeFiLlama estima los ingresos anuales del protocolo en $693K, con tarifas bajando un 23% en la última semana. Y CoinGecko muestra que el volumen de trading en 24 horas cayó un 72% en un solo día recientemente, lo cual es volátil incluso por estándares de cripto. Las datanets existen, los datos están ahí atribuidos y hashados, pero la demanda de inferencia que se suponía que debía fluir y compensar a los colaboradores proporcionalmente… aún no ha llegado a gran escala.
Seguí pensando en los primeros años de Ocean Protocol. La misma forma de problema — rico en infraestructura de oferta, esperando por demanda. La pregunta que OpenLedger aún no ha respondido no es si las redes de datos descentralizadas importan. Es qué es lo que realmente atrae a los constructores a consultar estas datanets específicas sobre alternativas centralizadas más baratas y rápidas.
Lo que me llamó la atención durante la tarea de OpenLedger $OPEN #OpenLedger @OpenLedger no fue la infraestructura — que es realmente interesante — sino darme cuenta de qué mitad de la red de datos está realmente funcionando. Las datanets están creciendo. Los colaboradores están subiendo, etiquetando, haciendo hashing. El lado de la oferta de la historia de datos descentralizados está activo y siendo recompensado a través de emisiones de tokens — la oferta circulante ha aumentado de 215.5M a aproximadamente 290M OPEN desde el TGE, según CoinMarketCap. Ese crecimiento es real y muestra que la gente está participando.
El lado de la demanda es una historia diferente. DeFiLlama estima los ingresos anuales del protocolo en $693K, con tarifas bajando un 23% en la última semana. Y CoinGecko muestra que el volumen de trading en 24 horas cayó un 72% en un solo día recientemente, lo cual es volátil incluso por estándares de cripto. Las datanets existen, los datos están ahí atribuidos y hashados, pero la demanda de inferencia que se suponía que debía fluir y compensar a los colaboradores proporcionalmente… aún no ha llegado a gran escala.
Seguí pensando en los primeros años de Ocean Protocol. La misma forma de problema — rico en infraestructura de oferta, esperando por demanda. La pregunta que OpenLedger aún no ha respondido no es si las redes de datos descentralizadas importan. Es qué es lo que realmente atrae a los constructores a consultar estas datanets específicas sobre alternativas centralizadas más baratas y rápidas.
El lado de la demanda es una historia diferente. DeFiLlama estima los ingresos anuales del protocolo en $693K, con tarifas bajando un 23% en la última semana. Y CoinGecko muestra que el volumen de trading en 24 horas cayó un 72% en un solo día recientemente, lo cual es volátil incluso por estándares de cripto. Las datanets existen, los datos están ahí atribuidos y hashados, pero la demanda de inferencia que se suponía que debía fluir y compensar a los colaboradores proporcionalmente… aún no ha llegado a gran escala.
Seguí pensando en los primeros años de Ocean Protocol. La misma forma de problema — rico en infraestructura de oferta, esperando por demanda. La pregunta que OpenLedger aún no ha respondido no es si las redes de datos descentralizadas importan. Es qué es lo que realmente atrae a los constructores a consultar estas datanets específicas sobre alternativas centralizadas más baratas y rápidas.
1
416
·
--
#openledger $OPEN Los datos abiertos y la IA descentralizada pueden desbloquear nuevas oportunidades en toda la industria blockchain. @OpenLedger está construyendo infraestructura que ayuda a conectar proveedores de datos y aplicaciones de IA, creando una utilidad real para el ecosistema. Deseando el futuro de $OPEN. #OpenLedger
#openledger $OPEN Los datos abiertos y la IA descentralizada pueden desbloquear nuevas oportunidades en toda la industria blockchain. @OpenLedger está construyendo infraestructura que ayuda a conectar proveedores de datos y aplicaciones de IA, creando una utilidad real para el ecosistema. Deseando el futuro de $OPEN . #OpenLedger
63
·
--
@Openledger El crecimiento que más me tiene emocionado no es cuántas billeteras activas ha aumentado, sino que su crecimiento no es "uniforme" en absoluto. $LAB
Esta semana revisé todos los datos de llamadas de Datanet, y la diferencia es absurda. Los datos financieros y de la cadena tienen una frecuencia de llamadas que supera a otros sectores por varias calles, mientras que muchas áreas están tan desiertas como una ciudad fantasma, colgadas ahí sin que nadie las mire. #BTC
Al principio pensé que esto era un problema, pero luego me di cuenta: esta extrema desigualdad es la verdadera señal de salud. El mercado está votando con dinero real: quien tenga datos que alguien quiera, atraerá a los contribuyentes. Esto no es una prosperidad falsa impulsada por los recursos del proyecto, es el resultado de una selección natural, cruel, pero real.
La lógica de distribución de Proof of Attribution obliga la atención de los contribuyentes a alejarse de "inflar números" hacia "realmente útil"; se basa en intereses económicos desnudos, no en gritos de la comunidad. Si lanzas un montón de datos basura que nadie llama, la recompensa de @Openledger será básicamente cero; si los datos que proporcionas son llamados con frecuencia, la recompensa será continua. La eficiencia de estos dos mecanismos es abismal, y la mayoría de los proyectos aún no han comprendido este punto.
Pero lo que más me preocupa ahora es esta espina de la calidad de los datos.
El problema de la calidad desigual de Datanet, aún no he visto una solución efectiva. Los datos de baja calidad mezclados arruinarán lentamente la reputación de toda la plataforma. Si los llamadores pisan el mismo bache varias veces, es muy probable que se vayan y no regresen. Esa es mi mayor preocupación: no es el precio de la moneda a corto plazo, es si, al expandirse, la calidad promedio de los datos puede resistir.
Y aquí se esconde una espiral mortal: cuanto más nicho sea el Datanet, menos llamadas tendrá, y cuanto menos llamadas, menos personas estarán dispuestas a contribuir con datos de calidad, al final solo quedará basura acumulándose. Las áreas populares devoran toda la atención, mientras que las de cola larga se mueren de hambre.
$OPEN Lo que quiero es un mercado de datos libre, pero un mercado libre tiende a polarizarse.
En los próximos seis meses, la verdadera tasa de eliminación de Datanet dirá más que cualquier número de billeteras activas. Encontrar un equilibrio entre "selección natural" y "marchitamiento de la cola larga" es un obstáculo que no puede evitar.
#OpenLedger
{alpha}(560x7ec43cf65f1663f820427c62a5780b8f2e25593a)
{spot}(OPENUSDT)
@OpenLedger El crecimiento que más me tiene emocionado no es cuántas billeteras activas ha aumentado, sino que su crecimiento no es "uniforme" en absoluto. $LAB
Esta semana revisé todos los datos de llamadas de Datanet, y la diferencia es absurda. Los datos financieros y de la cadena tienen una frecuencia de llamadas que supera a otros sectores por varias calles, mientras que muchas áreas están tan desiertas como una ciudad fantasma, colgadas ahí sin que nadie las mire. #BTC
Al principio pensé que esto era un problema, pero luego me di cuenta: esta extrema desigualdad es la verdadera señal de salud. El mercado está votando con dinero real: quien tenga datos que alguien quiera, atraerá a los contribuyentes. Esto no es una prosperidad falsa impulsada por los recursos del proyecto, es el resultado de una selección natural, cruel, pero real.
La lógica de distribución de Proof of Attribution obliga la atención de los contribuyentes a alejarse de "inflar números" hacia "realmente útil"; se basa en intereses económicos desnudos, no en gritos de la comunidad. Si lanzas un montón de datos basura que nadie llama, la recompensa de @OpenLedger será básicamente cero; si los datos que proporcionas son llamados con frecuencia, la recompensa será continua. La eficiencia de estos dos mecanismos es abismal, y la mayoría de los proyectos aún no han comprendido este punto.
Pero lo que más me preocupa ahora es esta espina de la calidad de los datos.
El problema de la calidad desigual de Datanet, aún no he visto una solución efectiva. Los datos de baja calidad mezclados arruinarán lentamente la reputación de toda la plataforma. Si los llamadores pisan el mismo bache varias veces, es muy probable que se vayan y no regresen. Esa es mi mayor preocupación: no es el precio de la moneda a corto plazo, es si, al expandirse, la calidad promedio de los datos puede resistir.
Y aquí se esconde una espiral mortal: cuanto más nicho sea el Datanet, menos llamadas tendrá, y cuanto menos llamadas, menos personas estarán dispuestas a contribuir con datos de calidad, al final solo quedará basura acumulándose. Las áreas populares devoran toda la atención, mientras que las de cola larga se mueren de hambre.
$OPEN Lo que quiero es un mercado de datos libre, pero un mercado libre tiende a polarizarse.
En los próximos seis meses, la verdadera tasa de eliminación de Datanet dirá más que cualquier número de billeteras activas. Encontrar un equilibrio entre "selección natural" y "marchitamiento de la cola larga" es un obstáculo que no puede evitar.
#OpenLedger
Esta semana revisé todos los datos de llamadas de Datanet, y la diferencia es absurda. Los datos financieros y de la cadena tienen una frecuencia de llamadas que supera a otros sectores por varias calles, mientras que muchas áreas están tan desiertas como una ciudad fantasma, colgadas ahí sin que nadie las mire. #BTC
Al principio pensé que esto era un problema, pero luego me di cuenta: esta extrema desigualdad es la verdadera señal de salud. El mercado está votando con dinero real: quien tenga datos que alguien quiera, atraerá a los contribuyentes. Esto no es una prosperidad falsa impulsada por los recursos del proyecto, es el resultado de una selección natural, cruel, pero real.
La lógica de distribución de Proof of Attribution obliga la atención de los contribuyentes a alejarse de "inflar números" hacia "realmente útil"; se basa en intereses económicos desnudos, no en gritos de la comunidad. Si lanzas un montón de datos basura que nadie llama, la recompensa de @OpenLedger será básicamente cero; si los datos que proporcionas son llamados con frecuencia, la recompensa será continua. La eficiencia de estos dos mecanismos es abismal, y la mayoría de los proyectos aún no han comprendido este punto.
Pero lo que más me preocupa ahora es esta espina de la calidad de los datos.
El problema de la calidad desigual de Datanet, aún no he visto una solución efectiva. Los datos de baja calidad mezclados arruinarán lentamente la reputación de toda la plataforma. Si los llamadores pisan el mismo bache varias veces, es muy probable que se vayan y no regresen. Esa es mi mayor preocupación: no es el precio de la moneda a corto plazo, es si, al expandirse, la calidad promedio de los datos puede resistir.
Y aquí se esconde una espiral mortal: cuanto más nicho sea el Datanet, menos llamadas tendrá, y cuanto menos llamadas, menos personas estarán dispuestas a contribuir con datos de calidad, al final solo quedará basura acumulándose. Las áreas populares devoran toda la atención, mientras que las de cola larga se mueren de hambre.
$OPEN Lo que quiero es un mercado de datos libre, pero un mercado libre tiende a polarizarse.
En los próximos seis meses, la verdadera tasa de eliminación de Datanet dirá más que cualquier número de billeteras activas. Encontrar un equilibrio entre "selección natural" y "marchitamiento de la cola larga" es un obstáculo que no puede evitar.
#OpenLedger
不均衡到底是好是坏
50%
数据质量这关怎么过
0%
冷门方向会被饿死吗
0%
我也想上传数据试试
50%
2 Votos • Votación cerrada
2
1
231
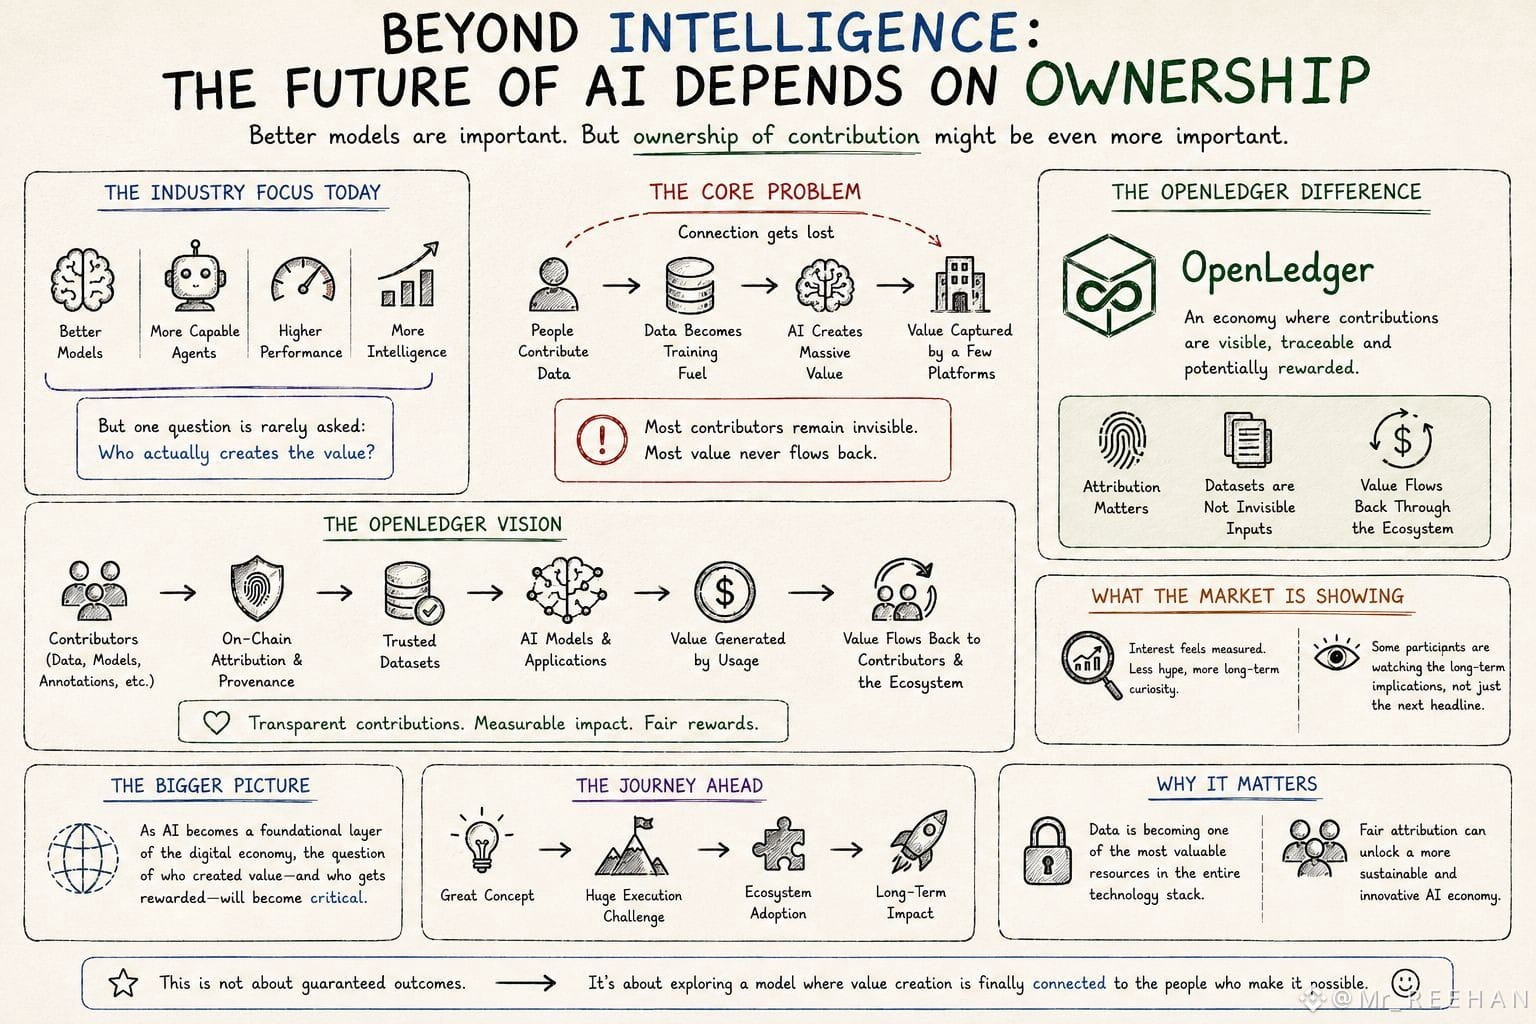
OPENLEDGER: QUIZÁS EL FUTURO NO SEA UN REY GIGANTE DE IACreo que el mundo de la IA tiene una extraña obsesión con el tamaño. Modelo más grande, mayor capacidad de cómputo, más benchmarks, anuncios más grandes. Todos quieren construir el cerebro gigante que lo sabe todo. Suena poderoso, sí... pero también un poco gracioso, porque la mitad del tiempo ese cerebro gigante aún responde mal a una simple pregunta de nicho con total confianza.
Por eso sigo mirando a OpenLedger desde un ángulo diferente. Quizás lo interesante no sea un modelo de IA masivo dominando todo. Tal vez la mejor historia sea muchos modelos más pequeños y enfocados que realmente conocen su trabajo. No un rey sentado sobre todo el conocimiento. Más bien como granjeros de modelos cultivando modelos útiles a partir de datos específicos.
OPENLEDGER: QUIZÁS EL FUTURO NO SEA UN REY GIGANTE DE IA
Creo que el mundo de la IA tiene una extraña obsesión con el tamaño. Modelo más grande, mayor capacidad de cómputo, más benchmarks, anuncios más grandes. Todos quieren construir el cerebro gigante que lo sabe todo. Suena poderoso, sí... pero también un poco gracioso, porque la mitad del tiempo ese cerebro gigante aún responde mal a una simple pregunta de nicho con total confianza.
Por eso sigo mirando a OpenLedger desde un ángulo diferente. Quizás lo interesante no sea un modelo de IA masivo dominando todo. Tal vez la mejor historia sea muchos modelos más pequeños y enfocados que realmente conocen su trabajo. No un rey sentado sobre todo el conocimiento. Más bien como granjeros de modelos cultivando modelos útiles a partir de datos específicos.
Por eso sigo mirando a OpenLedger desde un ángulo diferente. Quizás lo interesante no sea un modelo de IA masivo dominando todo. Tal vez la mejor historia sea muchos modelos más pequeños y enfocados que realmente conocen su trabajo. No un rey sentado sobre todo el conocimiento. Más bien como granjeros de modelos cultivando modelos útiles a partir de datos específicos.
463
OPENLEDGER ($OPEN) se siente como una de esas ideas que aparece cuando todo el mercado está medio cansado pero aún pretendiendo ser temprano
Datos de IA… modelos… agentes… todo convertido en algo que puedes alquilar, intercambiar, monetizar. suena poderoso, casi obvio, como que sí, claro que el conocimiento se volverá líquido algún día… pero luego me quedo ahí mirándolo y pienso, ¿por qué todo en cripto siempre se siente como si estuviera a un paso de ser real, y también a un paso de ser solo otra historia que seguimos repitiendo?
He visto este patrón antes. nueva narrativa, palabras grandes, las velas comienzan a moverse un poco, la gente empieza a imaginar un internet completamente nuevo siendo construido de la noche a la mañana… y tal vez algo se construya, lentamente, dolorosamente, pero la mayor parte solo se desvanece en servidores de Discord olvidados y docs medio actualizados
OpenLedger se sitúa justo en esa zona incómoda para mí. no tiene vibra de estafa, tampoco es un ganador garantizado. solo… energía incierta. como sostener un teléfono con 3 por ciento de batería y decidir si seguir desplazándome o aceptar la realidad y ponerlo a cargar
y sigo preguntándome, ¿quién realmente paga por el conocimiento de IA alquilado de una manera que se mantenga, no solo experimentos o incentivos? si esa respuesta se vuelve real, entonces sí… esto cambia. si no, es solo otra idea hermosa flotando en el espacio cripto, esperando la gravedad
por ahora solo lo estoy observando respirar, sin tocar, pero tampoco ignorando
@Openledger #OpenLedger $OPEN
{spot}(OPENUSDT)
OPENLEDGER ($OPEN ) se siente como una de esas ideas que aparece cuando todo el mercado está medio cansado pero aún pretendiendo ser temprano
Datos de IA… modelos… agentes… todo convertido en algo que puedes alquilar, intercambiar, monetizar. suena poderoso, casi obvio, como que sí, claro que el conocimiento se volverá líquido algún día… pero luego me quedo ahí mirándolo y pienso, ¿por qué todo en cripto siempre se siente como si estuviera a un paso de ser real, y también a un paso de ser solo otra historia que seguimos repitiendo?
He visto este patrón antes. nueva narrativa, palabras grandes, las velas comienzan a moverse un poco, la gente empieza a imaginar un internet completamente nuevo siendo construido de la noche a la mañana… y tal vez algo se construya, lentamente, dolorosamente, pero la mayor parte solo se desvanece en servidores de Discord olvidados y docs medio actualizados
OpenLedger se sitúa justo en esa zona incómoda para mí. no tiene vibra de estafa, tampoco es un ganador garantizado. solo… energía incierta. como sostener un teléfono con 3 por ciento de batería y decidir si seguir desplazándome o aceptar la realidad y ponerlo a cargar
y sigo preguntándome, ¿quién realmente paga por el conocimiento de IA alquilado de una manera que se mantenga, no solo experimentos o incentivos? si esa respuesta se vuelve real, entonces sí… esto cambia. si no, es solo otra idea hermosa flotando en el espacio cripto, esperando la gravedad
por ahora solo lo estoy observando respirar, sin tocar, pero tampoco ignorando
@OpenLedger #OpenLedger $OPEN
Datos de IA… modelos… agentes… todo convertido en algo que puedes alquilar, intercambiar, monetizar. suena poderoso, casi obvio, como que sí, claro que el conocimiento se volverá líquido algún día… pero luego me quedo ahí mirándolo y pienso, ¿por qué todo en cripto siempre se siente como si estuviera a un paso de ser real, y también a un paso de ser solo otra historia que seguimos repitiendo?
He visto este patrón antes. nueva narrativa, palabras grandes, las velas comienzan a moverse un poco, la gente empieza a imaginar un internet completamente nuevo siendo construido de la noche a la mañana… y tal vez algo se construya, lentamente, dolorosamente, pero la mayor parte solo se desvanece en servidores de Discord olvidados y docs medio actualizados
OpenLedger se sitúa justo en esa zona incómoda para mí. no tiene vibra de estafa, tampoco es un ganador garantizado. solo… energía incierta. como sostener un teléfono con 3 por ciento de batería y decidir si seguir desplazándome o aceptar la realidad y ponerlo a cargar
y sigo preguntándome, ¿quién realmente paga por el conocimiento de IA alquilado de una manera que se mantenga, no solo experimentos o incentivos? si esa respuesta se vuelve real, entonces sí… esto cambia. si no, es solo otra idea hermosa flotando en el espacio cripto, esperando la gravedad
por ahora solo lo estoy observando respirar, sin tocar, pero tampoco ignorando
@OpenLedger #OpenLedger $OPEN
2
2
164
·
--

Artículo
OPENLEDGER ESTÁ CONSTRUYENDO LA BASE DE UNA IA CONFIABLERecientemente estaba leyendo sobre el envenenamiento de datos y me llevó a una pregunta que parece mucho más grande que el ataque en sí.
La mayoría de las conversaciones sobre la IA parecen centrarse en la capacidad. Cada semana se discute sobre modelos más potentes, ventanas de contexto más amplias, mejores benchmarks, costos de inferencia más bajos y más potencia de cómputo. Esos desarrollos son importantes, pero me pregunto si otro desafío merece mucha más atención.
¿Qué pasa cuando los datos de los que depende la IA ya no se pueden confiar?
OPENLEDGER ESTÁ CONSTRUYENDO LA BASE DE UNA IA CONFIABLE
Recientemente estaba leyendo sobre el envenenamiento de datos y me llevó a una pregunta que parece mucho más grande que el ataque en sí.
La mayoría de las conversaciones sobre la IA parecen centrarse en la capacidad. Cada semana se discute sobre modelos más potentes, ventanas de contexto más amplias, mejores benchmarks, costos de inferencia más bajos y más potencia de cómputo. Esos desarrollos son importantes, pero me pregunto si otro desafío merece mucha más atención.
¿Qué pasa cuando los datos de los que depende la IA ya no se pueden confiar?
La mayoría de las conversaciones sobre la IA parecen centrarse en la capacidad. Cada semana se discute sobre modelos más potentes, ventanas de contexto más amplias, mejores benchmarks, costos de inferencia más bajos y más potencia de cómputo. Esos desarrollos son importantes, pero me pregunto si otro desafío merece mucha más atención.
¿Qué pasa cuando los datos de los que depende la IA ya no se pueden confiar?
12
7
334
·
--
#openledger $OPEN las redes de infraestructura física descentralizada están transformando el paisaje de la IA y @Openledger está a la vanguardia de este cambio
Los protocolos de capa de datos segura son esenciales para entrenar modelos de IA correctamente
Vigilando cuidadosamente el token abierto a medida que la mainnet se expande #OpenLedger #Binance #crypto $OPEN
{spot}(OPENUSDT)
$BNB
{spot}(BNBUSDT)
#openledger $OPEN las redes de infraestructura física descentralizada están transformando el paisaje de la IA y @OpenLedger está a la vanguardia de este cambio
Los protocolos de capa de datos segura son esenciales para entrenar modelos de IA correctamente
Vigilando cuidadosamente el token abierto a medida que la mainnet se expande #OpenLedger #Binance #crypto $OPEN
$BNB
Los protocolos de capa de datos segura son esenciales para entrenar modelos de IA correctamente
Vigilando cuidadosamente el token abierto a medida que la mainnet se expande #OpenLedger #Binance #crypto $OPEN
$BNB
60
·
--

Artículo
OpenLedger Se Siente Como Una de Esas Ideas Que Crypto Sigue Pretendiendo Que Ya ResolvióHe estado en esta industria el tiempo suficiente para dejar de reaccionar cada vez que alguien dice las palabras “próximo ciclo.” Cada ciclo es, aparentemente, el que finalmente hará que las criptos sean útiles, populares, inteligentes, escalables, descentralizadas, sostenibles, impulsadas por IA, de propiedad de creadores, adoptadas institucionalmente, y cualquier otra frase que se recicla en un lema de conferencia. Y de alguna manera, después de todos estos años, seguimos gastando la mitad de nuestro tiempo viendo a la gente cultivar engagement en Twitter mientras el usuario promedio lucha por explicar por qué siquiera necesita una billetera.
OpenLedger Se Siente Como Una de Esas Ideas Que Crypto Sigue Pretendiendo Que Ya Resolvió
He estado en esta industria el tiempo suficiente para dejar de reaccionar cada vez que alguien dice las palabras “próximo ciclo.” Cada ciclo es, aparentemente, el que finalmente hará que las criptos sean útiles, populares, inteligentes, escalables, descentralizadas, sostenibles, impulsadas por IA, de propiedad de creadores, adoptadas institucionalmente, y cualquier otra frase que se recicla en un lema de conferencia. Y de alguna manera, después de todos estos años, seguimos gastando la mitad de nuestro tiempo viendo a la gente cultivar engagement en Twitter mientras el usuario promedio lucha por explicar por qué siquiera necesita una billetera.
163
·
--
#openledger $OPEN @Openledger
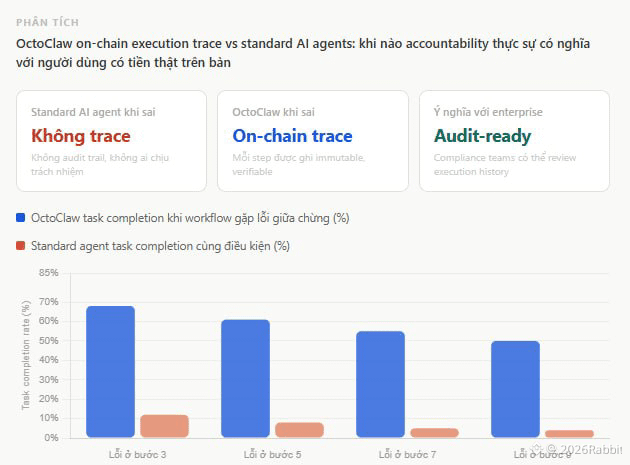
Una tarde estaba probando OctoClaw y le dejé realizar una serie de tareas relacionadas con la investigación de DeFi. Todo funcionaba bastante fluido hasta el séptimo paso del workflow. El agente llegó a una conclusión errónea sobre el liquidity pool de un protocolo que estaba siguiendo. No fue un error menor. Fue un error del tipo que, si hubiera confiado en él y colocado una orden real, habría perdido dinero real.
Y allí estaba yo, preguntándome algo que creo que pocas personas se detienen a cuestionar: ¿quién es responsable de ese error?
Con ChatGPT o Claude, la respuesta simple es "AI disclaimer, úsalo bajo tu propio riesgo." Pero con OctoClaw en OpenLedger, hay algo diferente. Cada acción del agente queda registrada en la cadena. La ejecución no se puede borrar. Si el agente se equivoca, la huella de ese error existe para siempre y es verificable por cualquiera. Esa fue la primera vez que vi que la responsabilidad de la IA ya no era un concepto abstracto, sino una garantía técnica.
El error de aquel día de OctoClaw me hizo confiar más en OpenLedger que en cualquier otra cosa. Porque pude ver exactamente dónde estaba el error, por qué, y tuve el contexto suficiente para decidir si confiar en el agente la próxima vez. Eso es algo que ningún otro agente de IA me ha podido ofrecer.
¿Alguna vez has dejado que un agente de IA realice una acción real con dinero real, y qué te hizo lo suficientemente confiado para hacerlo?
#openledger $OPEN @OpenLedger
Una tarde estaba probando OctoClaw y le dejé realizar una serie de tareas relacionadas con la investigación de DeFi. Todo funcionaba bastante fluido hasta el séptimo paso del workflow. El agente llegó a una conclusión errónea sobre el liquidity pool de un protocolo que estaba siguiendo. No fue un error menor. Fue un error del tipo que, si hubiera confiado en él y colocado una orden real, habría perdido dinero real.
Y allí estaba yo, preguntándome algo que creo que pocas personas se detienen a cuestionar: ¿quién es responsable de ese error?
Con ChatGPT o Claude, la respuesta simple es "AI disclaimer, úsalo bajo tu propio riesgo." Pero con OctoClaw en OpenLedger, hay algo diferente. Cada acción del agente queda registrada en la cadena. La ejecución no se puede borrar. Si el agente se equivoca, la huella de ese error existe para siempre y es verificable por cualquiera. Esa fue la primera vez que vi que la responsabilidad de la IA ya no era un concepto abstracto, sino una garantía técnica.
El error de aquel día de OctoClaw me hizo confiar más en OpenLedger que en cualquier otra cosa. Porque pude ver exactamente dónde estaba el error, por qué, y tuve el contexto suficiente para decidir si confiar en el agente la próxima vez. Eso es algo que ningún otro agente de IA me ha podido ofrecer.
¿Alguna vez has dejado que un agente de IA realice una acción real con dinero real, y qué te hizo lo suficientemente confiado para hacerlo?
Una tarde estaba probando OctoClaw y le dejé realizar una serie de tareas relacionadas con la investigación de DeFi. Todo funcionaba bastante fluido hasta el séptimo paso del workflow. El agente llegó a una conclusión errónea sobre el liquidity pool de un protocolo que estaba siguiendo. No fue un error menor. Fue un error del tipo que, si hubiera confiado en él y colocado una orden real, habría perdido dinero real.
Y allí estaba yo, preguntándome algo que creo que pocas personas se detienen a cuestionar: ¿quién es responsable de ese error?
Con ChatGPT o Claude, la respuesta simple es "AI disclaimer, úsalo bajo tu propio riesgo." Pero con OctoClaw en OpenLedger, hay algo diferente. Cada acción del agente queda registrada en la cadena. La ejecución no se puede borrar. Si el agente se equivoca, la huella de ese error existe para siempre y es verificable por cualquiera. Esa fue la primera vez que vi que la responsabilidad de la IA ya no era un concepto abstracto, sino una garantía técnica.
El error de aquel día de OctoClaw me hizo confiar más en OpenLedger que en cualquier otra cosa. Porque pude ver exactamente dónde estaba el error, por qué, y tuve el contexto suficiente para decidir si confiar en el agente la próxima vez. Eso es algo que ningún otro agente de IA me ha podido ofrecer.
¿Alguna vez has dejado que un agente de IA realice una acción real con dinero real, y qué te hizo lo suficientemente confiado para hacerlo?
192
·
--
En los últimos días, he estado en el tablero de gobernanza de OpenLedger, observando cómo las ballenas votan. Cuanto más miro, más me doy cuenta de que esta supuesta gobernanza descentralizada es una broma elaborada. En la superficie, todos pueden proponer y votar, suena muy democrático, pero si realmente miras la distribución de los pesos de voto, te das cuenta de que los pequeños inversores no tienen suficiente peso ni para hacerle cosquillas a los grandes capitales. $LAB
He seguido varias rondas de propuestas y el patrón es muy claro. Ese ajuste de peso dinámico, hoy se inclina hacia un equipo grande de modelos, dándole recompensas a los datos de texto; mañana, con un cambio de viento, se pueden volver a subsidiar la renderización de video. El discurso externo es siempre sobre optimizar el ecosistema y responder a la demanda, pero las decisiones siempre las toman esas pocas direcciones tempranas que sostienen un montón de fichas. Los pequeños en este sistema no son realmente co-creadores, más bien parecen herramientas de votación baratas, manipuladas por algoritmos y capital; si una propuesta va a pasar ya está decidido de antemano, la votación solo es un trámite para mostrar.
Más inquietante es ese tipo de secuestro de flujo disfrazado. Cada mes, la cantidad de fichas liberadas depende completamente del verdadero volumen de bloqueo y frecuencia de uso de cada red vertical, lo que obliga a los equipos de subred a usar datos operativos reales para competir por fondos. Suena justo, pero deduzco que, una vez que se agoten los beneficios iniciales, esas pocas ballenas que tienen un montón de fichas seguramente se aliarán en secreto, creando redes fantasmas para mover fondos de mano en mano, extrayendo recompensas inflacionarias y vaciando el pool de ganancias de los pequeños. La siguiente pregunta es cómo equilibrar esta conspiración de capital que chupa sangre, un nudo que el equipo no puede evitar. $BTC
No digo que este proyecto sea malo, tiene el valor de escribir directamente la lógica de distribución en el código, sin depender de la gestión de personas; esta valentía es realmente rara en el espacio. Pero los peligros de centralización en la gobernanza son reales. Hasta que no se resuelva el tema de las alianzas de las ballenas, es mejor que los pequeños inversores reconozcan su posición en la mesa de juego y no se engañen pensando que pueden cambiar las reglas como accionistas. #OpenLedger $OPEN @Openledger
En los últimos días, he estado en el tablero de gobernanza de OpenLedger, observando cómo las ballenas votan. Cuanto más miro, más me doy cuenta de que esta supuesta gobernanza descentralizada es una broma elaborada. En la superficie, todos pueden proponer y votar, suena muy democrático, pero si realmente miras la distribución de los pesos de voto, te das cuenta de que los pequeños inversores no tienen suficiente peso ni para hacerle cosquillas a los grandes capitales. $LAB
He seguido varias rondas de propuestas y el patrón es muy claro. Ese ajuste de peso dinámico, hoy se inclina hacia un equipo grande de modelos, dándole recompensas a los datos de texto; mañana, con un cambio de viento, se pueden volver a subsidiar la renderización de video. El discurso externo es siempre sobre optimizar el ecosistema y responder a la demanda, pero las decisiones siempre las toman esas pocas direcciones tempranas que sostienen un montón de fichas. Los pequeños en este sistema no son realmente co-creadores, más bien parecen herramientas de votación baratas, manipuladas por algoritmos y capital; si una propuesta va a pasar ya está decidido de antemano, la votación solo es un trámite para mostrar.
Más inquietante es ese tipo de secuestro de flujo disfrazado. Cada mes, la cantidad de fichas liberadas depende completamente del verdadero volumen de bloqueo y frecuencia de uso de cada red vertical, lo que obliga a los equipos de subred a usar datos operativos reales para competir por fondos. Suena justo, pero deduzco que, una vez que se agoten los beneficios iniciales, esas pocas ballenas que tienen un montón de fichas seguramente se aliarán en secreto, creando redes fantasmas para mover fondos de mano en mano, extrayendo recompensas inflacionarias y vaciando el pool de ganancias de los pequeños. La siguiente pregunta es cómo equilibrar esta conspiración de capital que chupa sangre, un nudo que el equipo no puede evitar. $BTC
No digo que este proyecto sea malo, tiene el valor de escribir directamente la lógica de distribución en el código, sin depender de la gestión de personas; esta valentía es realmente rara en el espacio. Pero los peligros de centralización en la gobernanza son reales. Hasta que no se resuelva el tema de las alianzas de las ballenas, es mejor que los pequeños inversores reconozcan su posición en la mesa de juego y no se engañen pensando que pueden cambiar las reglas como accionistas. #OpenLedger $OPEN @OpenLedger
He seguido varias rondas de propuestas y el patrón es muy claro. Ese ajuste de peso dinámico, hoy se inclina hacia un equipo grande de modelos, dándole recompensas a los datos de texto; mañana, con un cambio de viento, se pueden volver a subsidiar la renderización de video. El discurso externo es siempre sobre optimizar el ecosistema y responder a la demanda, pero las decisiones siempre las toman esas pocas direcciones tempranas que sostienen un montón de fichas. Los pequeños en este sistema no son realmente co-creadores, más bien parecen herramientas de votación baratas, manipuladas por algoritmos y capital; si una propuesta va a pasar ya está decidido de antemano, la votación solo es un trámite para mostrar.
Más inquietante es ese tipo de secuestro de flujo disfrazado. Cada mes, la cantidad de fichas liberadas depende completamente del verdadero volumen de bloqueo y frecuencia de uso de cada red vertical, lo que obliga a los equipos de subred a usar datos operativos reales para competir por fondos. Suena justo, pero deduzco que, una vez que se agoten los beneficios iniciales, esas pocas ballenas que tienen un montón de fichas seguramente se aliarán en secreto, creando redes fantasmas para mover fondos de mano en mano, extrayendo recompensas inflacionarias y vaciando el pool de ganancias de los pequeños. La siguiente pregunta es cómo equilibrar esta conspiración de capital que chupa sangre, un nudo que el equipo no puede evitar. $BTC
No digo que este proyecto sea malo, tiene el valor de escribir directamente la lógica de distribución en el código, sin depender de la gestión de personas; esta valentía es realmente rara en el espacio. Pero los peligros de centralización en la gobernanza son reales. Hasta que no se resuelva el tema de las alianzas de las ballenas, es mejor que los pequeños inversores reconozcan su posición en la mesa de juego y no se engañen pensando que pueden cambiar las reglas como accionistas. #OpenLedger $OPEN @OpenLedger
散户投票权重有多惨
33%
动态权重调整谁说了算
67%
3 Votos • Votación cerrada
2
1
540
·
--
Mientras trabajaba en CreatorPad, una cosa se volvió imposible de ignorar: la atribución se vuelve mucho más complicada en cuanto aumenta la complejidad.
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@Openledger | #OpenLedger
$OPEN
{future}(OPENUSDT)
Mientras trabajaba en CreatorPad, una cosa se volvió imposible de ignorar: la atribución se vuelve mucho más complicada en cuanto aumenta la complejidad.
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@OpenLedger | #OpenLedger
$OPEN
OpenLedger busca hacer que cada contribución sea medible, pero el desafío no es rastrear la influencia, sino decidir cuánta influencia realmente importa. Cuanto más profunda es la cadena de entradas, más fácil se vuelve que los contribuyentes significativos desaparezcan detrás de modelos de puntuación simplificados.
La verdadera prueba para la atribución de IA no es la transparencia. Es si los contribuyentes de larga cola pueden retener su parte del valor a medida que las redes escalan.
@OpenLedger | #OpenLedger
$OPEN
2
2
70

·
--
La propiedad de datos en IA se habla a menudo como si ya estuviera claramente definida, pero en la práctica aún se siente inestable. Sistemas de atribución como OpenLedger traen estructura a algo que históricamente ha sido vago. Hacen visible la contribución, mapean dónde fluyen los datos y introducen un nivel de transparencia que faltaba durante mucho tiempo.
Pero la visibilidad por sí sola no se traduce completamente en propiedad. El significado legal y ético del control sobre los datos sigue siendo diferente de la capacidad técnica para rastrearlos. La blockchain puede registrar el origen y el movimiento con precisión, sin embargo, no resuelve automáticamente las preguntas de permiso, retiro o derechos a largo plazo.
También hay una descoordinación más profunda entre la permanencia y los marcos de privacidad. Los sistemas construidos para registros inmutables no se alinean fácilmente con las expectativas moldeadas por las leyes modernas de protección de datos. Al mismo tiempo, la mayoría de los datos que alimentan los sistemas de IA actuales ya existen fuera de cualquier estructura de consentimiento limpio, lo que hace que el desafío sea aún más difícil de abordar en retrospectiva.
@Openledger #openledger $OPEN
{spot}(OPENUSDT)
La propiedad de datos en IA se habla a menudo como si ya estuviera claramente definida, pero en la práctica aún se siente inestable. Sistemas de atribución como OpenLedger traen estructura a algo que históricamente ha sido vago. Hacen visible la contribución, mapean dónde fluyen los datos y introducen un nivel de transparencia que faltaba durante mucho tiempo.
Pero la visibilidad por sí sola no se traduce completamente en propiedad. El significado legal y ético del control sobre los datos sigue siendo diferente de la capacidad técnica para rastrearlos. La blockchain puede registrar el origen y el movimiento con precisión, sin embargo, no resuelve automáticamente las preguntas de permiso, retiro o derechos a largo plazo.
También hay una descoordinación más profunda entre la permanencia y los marcos de privacidad. Los sistemas construidos para registros inmutables no se alinean fácilmente con las expectativas moldeadas por las leyes modernas de protección de datos. Al mismo tiempo, la mayoría de los datos que alimentan los sistemas de IA actuales ya existen fuera de cualquier estructura de consentimiento limpio, lo que hace que el desafío sea aún más difícil de abordar en retrospectiva.
@OpenLedger #openledger $OPEN
Pero la visibilidad por sí sola no se traduce completamente en propiedad. El significado legal y ético del control sobre los datos sigue siendo diferente de la capacidad técnica para rastrearlos. La blockchain puede registrar el origen y el movimiento con precisión, sin embargo, no resuelve automáticamente las preguntas de permiso, retiro o derechos a largo plazo.
También hay una descoordinación más profunda entre la permanencia y los marcos de privacidad. Los sistemas construidos para registros inmutables no se alinean fácilmente con las expectativas moldeadas por las leyes modernas de protección de datos. Al mismo tiempo, la mayoría de los datos que alimentan los sistemas de IA actuales ya existen fuera de cualquier estructura de consentimiento limpio, lo que hace que el desafío sea aún más difícil de abordar en retrospectiva.
@OpenLedger #openledger $OPEN
4
9
363
·
--
#openledger $OPEN Hablando claro, ya estoy un poco cansado de la palabra “código abierto”. Lo que realmente me hace detenerme un segundo con @Openledger no es que digan que son de código abierto, sino si vibecoding puede generar esas pequeñas piezas que permiten que "lo que escribiste no se deseche, sino que puedas conectarlo directamente la próxima vez". Porque en esto de la pila de ejecución, al final lo que importa no es una super función, sino un montón de componentes discretos pero esenciales: previsualización de acciones, alertas de elementos faltantes, corrección de formato, visualización de pasos, comparación de diferencias... Estos son los cimientos que realmente permiten que research→action→execute funcione.
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @Openledger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@Openledger $OPEN #OpenLedger
#openledger $OPEN Hablando claro, ya estoy un poco cansado de la palabra “código abierto”. Lo que realmente me hace detenerme un segundo con @OpenLedger no es que digan que son de código abierto, sino si vibecoding puede generar esas pequeñas piezas que permiten que "lo que escribiste no se deseche, sino que puedas conectarlo directamente la próxima vez". Porque en esto de la pila de ejecución, al final lo que importa no es una super función, sino un montón de componentes discretos pero esenciales: previsualización de acciones, alertas de elementos faltantes, corrección de formato, visualización de pasos, comparación de diferencias... Estos son los cimientos que realmente permiten que research→action→execute funcione.
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @OpenLedger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@OpenLedger $OPEN #OpenLedger
Mi propia experiencia es bastante realista: en el momento en que OctoClaw lanza la acción, lo que más suele fallar no es la lógica de la estrategia, sino que no te diste cuenta de la dependencia de un paso en la acción, un parámetro fue tragado por un valor predeterminado, o una condición se escribió de manera demasiado vaga. Si te basas solo en tus ojos, tarde o temprano te vas a perder; con perder una vez es suficiente para que estés incómodo toda la semana. Por eso, me importa más si vibecoding puede transformar esos “puntos de riesgo” en herramientas, en lugar de tener que estar esquivando peligros cada vez con la cabeza. Hoy agregas un verificador de acción, mañana añades un diff de acción, comparando dos borradores de acción para ver qué paso cambió; pasado mañana agregas un formulario de entrada, estableciendo los campos obligatorios y el formato — eso sí que es hacer que la pila de ejecución se vuelva más fuerte.
Hoy solo dejo un punto de aceptación (también el que mejor puede distinguir entre “ruido” y “ecosistema”): ¿aparecen esos componentes generales que son usados repetidamente por muchos y siguen siendo mejorados? No es solo que me sienta bien escribiéndolo, sino que otros también están dispuestos a forkear, a proponer cambios, a integrarlo de nuevo en su flujo. Mientras esta cadena de reutilización funcione, @OpenLedger no es solo una actualización de producto, sino que está formando una verdadera caja de herramientas de ejecución que puede sedimentarse.
@OpenLedger $OPEN #OpenLedger
75
Inicia sesión para explorar más contenidos
Únete a usuarios de criptomonedas de todo el mundo en Binance Square
⚡️ Obtén la información más reciente y útil sobre criptomonedas.
💬 Confía en el mayor exchange de criptomonedas del mundo.
👍 Descubre opiniones reales de creadores verificados.
Correo electrónico/número de teléfono
Temas en tendencia
1
#CryptoSelloffTriggersMultipleWhaleLiquidations
165,944 visualizaciones
1,712 participa(n) en el debate
2
#USSpotXRPETFsSeeLargestWeeklyOutflowIn8Months
151,318 visualizaciones
1,512 participa(n) en el debate
3
#WillFOMCMinutesReinforceRateHikeExpectations?
43,426 visualizaciones
710 participa(n) en el debate
4
#BitcoinActiveSupplyInProfitDropsBelow45%
226,912 visualizaciones
1,773 participa(n) en el debate
5
#TONStrategyReports$23.97MQ3NetLoss
19,758 visualizaciones
147 participa(n) en el debate
6
#KavaSaysAbnormalActivityLimitedToKavaLend
150,806 visualizaciones
1,006 participa(n) en el debate
7
#WORPTLetsTouristsConvertCryptoToThaiBaht
53,203 visualizaciones
405 participa(n) en el debate
8
#WhoWillSucceedJensenHuangatNvidia?
349,533 visualizaciones
2,150 participa(n) en el debate
9
#WhatWillDriveCryptoandStocks’NextRebound?
874,723 visualizaciones
3,963 participa(n) en el debate
10
#TradFiForBeginners
846,266 visualizaciones
4,974 participa(n) en el debate